Category
Cost-Aware AI Systems
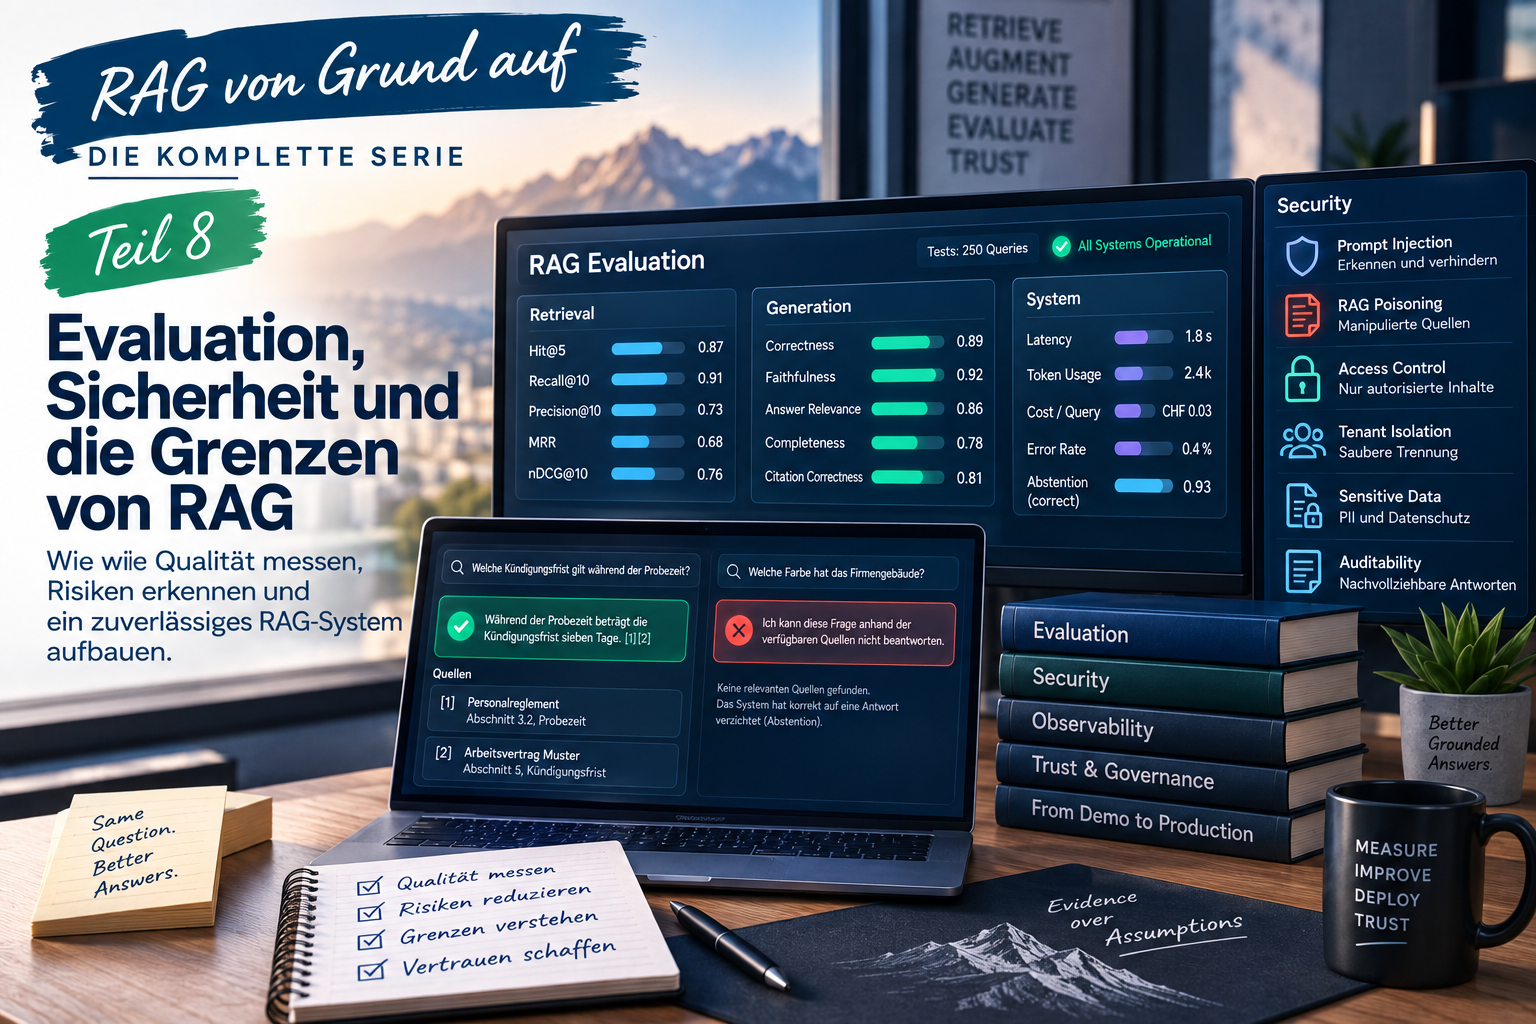
Ein RAG-System kann technisch einwandfrei funktionieren und trotzdem schlechte Antworten liefern. Der Vector Store antwortet. Die Embeddings wurden erzeugt. BM25 liefert Treffer. Hybrid Search funktioniert. Der Reranker sortiert Kandidaten. Das LLM generiert…
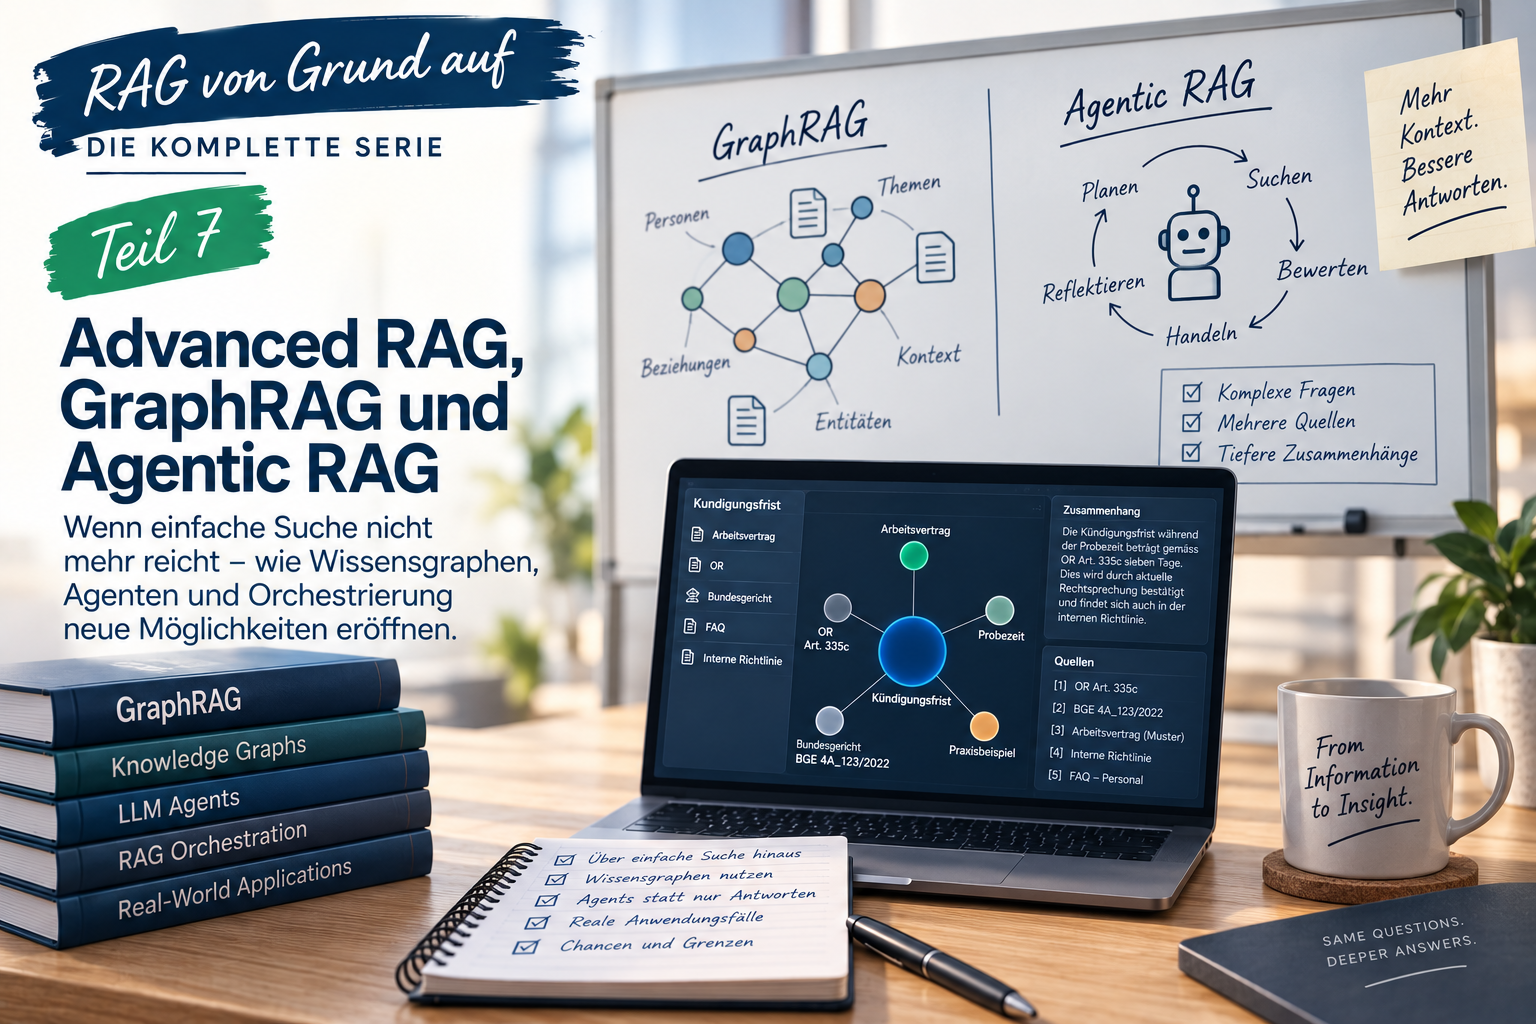
In den bisherigen Teilen haben wir eine klassische RAG-Pipeline Schritt für Schritt aufgebaut. Aus Dokumenten wurden Chunks. Aus Chunks wurden durch Embeddings Vektoren. Dense Retrieval und Sparse Retrieval ermöglichten unterschiedliche Arten der…
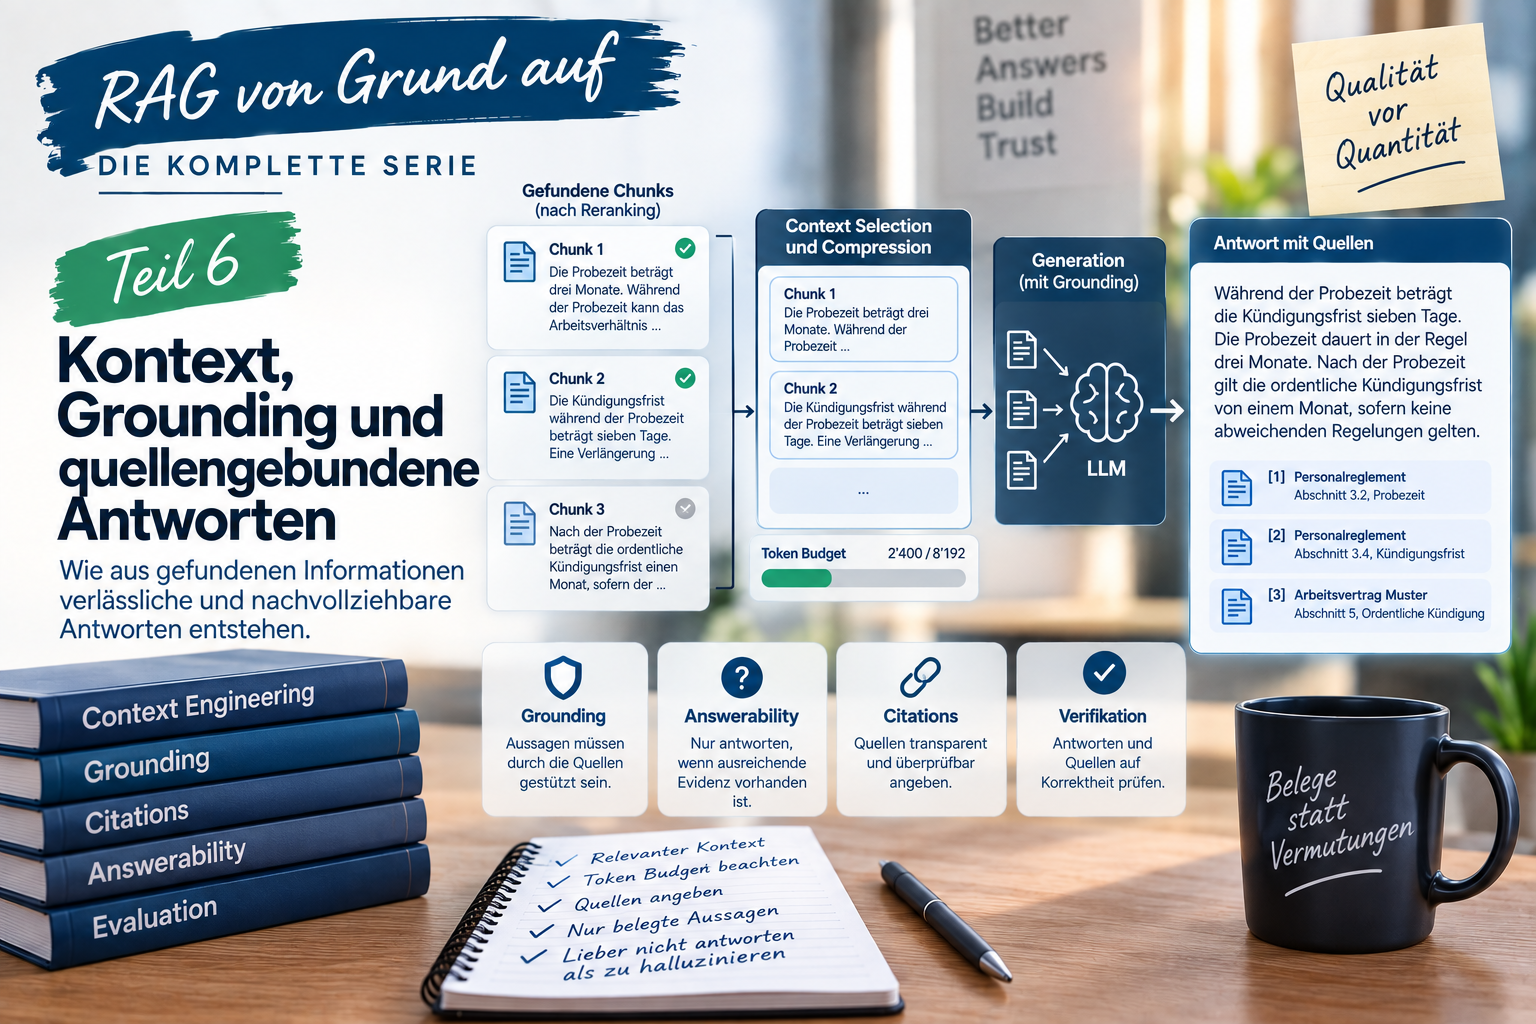
Bis hierhin haben wir einen grossen Teil der RAG-Pipeline aufgebaut. Wir können Dokumente verarbeiten. Wir können sie in sinnvolle Chunks zerlegen. Wir können Embeddings erzeugen. Wir können semantisch und lexikalisch suchen. Wir…
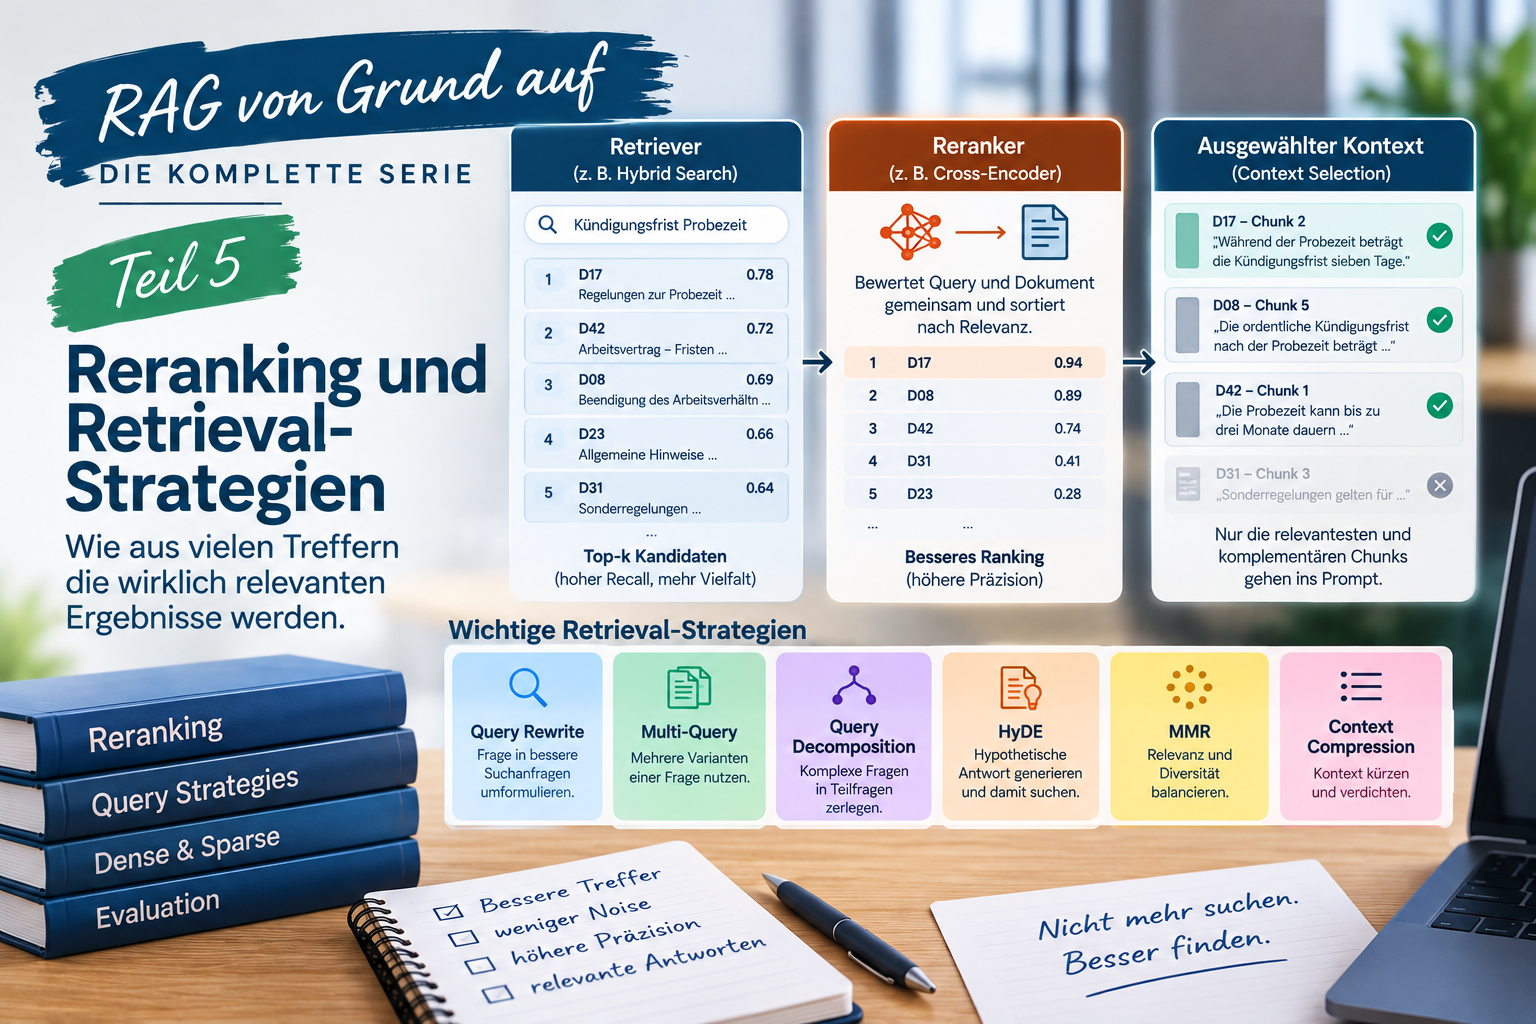
In Teil 4 haben wir gesehen, wie Dense Retrieval und Sparse Retrieval kombiniert werden können. Eine typische Pipeline sah am Ende ungefähr so aus: Damit haben wir allerdings noch nicht zwangsläufig die…

In Teil 3 ging es um Embeddings und Vektorsuche. Wir haben gesehen, dass Dense Retrieval besonders stark darin ist, semantisch ähnliche Inhalte zu finden. Beispiel: Dokument: Die Wörter stimmen nur teilweise überein.…

In Teil 1 haben wir RAG als Zusammenspiel von Retrieval, Augmentation und Generation betrachtet. In Teil 2 ging es darum, wie Dokumente durch Parsing, OCR und Chunking überhaupt erst in durchsuchbare Informationseinheiten…

Im ersten Teil ging es um die Grundidee von Retrieval-Augmented Generation: Damit ein System überhaupt sinnvoll retrieven kann, muss Wissen zuerst in eine Form gebracht werden, die sich durchsuchen lässt. Genau hier…

Retrieval-Augmented Generation, kurz RAG, gehört inzwischen zu den zentralen Konzepten beim Einsatz von Large Language Models mit eigenem Wissen. Die Grundidee klingt zunächst erstaunlich einfach: Bevor ein Sprachmodell eine Frage beantwortet, werden…

Tokens, Kontext, Caching und agentische Loops als Referenzwerk „Was kostet es, wenn ich acht Stunden am Tag mit einem Coding Agent arbeite?“ Die Frage klingt nach einer einfachen Rechnung. Acht Stunden Nutzung,…
Field NoteAI EngineeringFR
A Five-File Briefing Pack That Keeps Small Models Inside the Spec Most teams start a coding agent with the repository and a sentence. That sounds sufficient. The files are there. The tests…
Field NoteAI EngineeringFR
The Terms You Need Before “Just Run It Locally” Makes Sense Most introductions to local AI start with a download command. That sounds like enough. You install a runtime. You pull a…
Field NoteAI EngineeringFR
Running Qwen Code on Ollama Is an Architecture Problem, Not a Prompt Problem Most local coding setups start with a simple assumption: pull a strong model, point the agent at localhost:11434, and…
No articles in this year.